
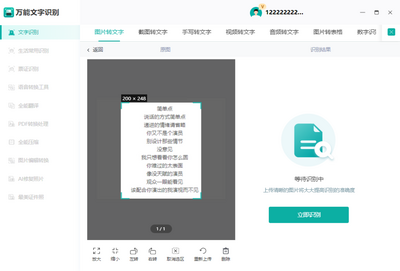
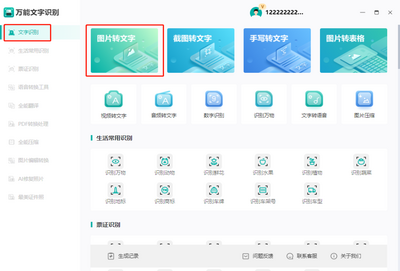
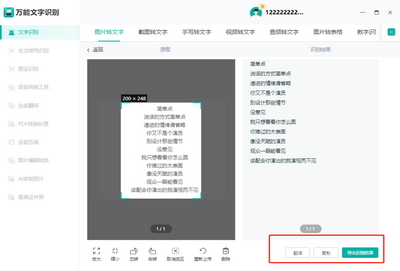
万能文字识别电脑版是一款集成了前沿OCR光学字符识别技术的专业文字提取工具,能够高效精准地从图片、截图、扫描件乃至PDF文档中识别并提取文字信息。软件支持印刷体与手写体识别,并具备批量处理、多语言翻译、表格还原等实用功能,广泛应用于办公学习、资料整理、数据录入等场景。其简洁直观的操作界面与本地化处理机制,在保障数据安全的同时,极大提升了用户的工作效率,是个人及商务用户不可或缺的智能文字处理助手。
万能文字识别电脑版如何进行批量识别图片文字?
1. 首先,在电脑上下载并安装万能文字识别电脑版,确保使用的是最新稳定版本。
2. 打开软件,在主界面找到并点击“批量识别”功能模块,进入文件添加页面。
3. 点击“添加文件”或“添加文件夹”按钮,从本地磁盘中选中需要识别的多张图片(支持JPG、PNG、BMP等常见格式),或直接拖拽图片文件到指定区域。
4. 在批量设置选项中,根据需求选择输出格式(如TXT、Word、Excel)以及识别语言(中文、英文等),并可勾选“自动旋转校正”或“去噪优化”提升准确率。
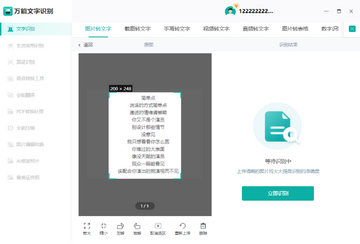
5. 点击“开始识别”按钮,软件将自动逐张处理图片并提取文字,处理完成后会弹出结果预览窗口。
6. 在结果预览中,可手动校对或修改个别识别错误的文字,确认无误后点击“导出”按钮,将所有识别结果保存到指定文件夹。
7. 建议保持网络畅通,部分高级功能可能需要联网更新识别模型,以获得更好的识别效果。
万能文字识别电脑版识别准确率怎么样?如何提高识别效果?
1. 万能文字识别电脑版采用深度学习算法,对印刷体文字的识别准确率可达98%以上,对手写体的识别准确率在85%左右,具体效果受图片质量影响。
2. 提高识别效果的首要方法是保证图片清晰度,尽量使用高分辨率图片,避免模糊、倾斜或光线不足。
3. 在识别前,可利用软件自带的“图片预处理”功能,对图片进行灰度化、二值化、去噪点、旋转校正等操作,显著提升识别成功率。
4. 对于复杂背景或彩色图片,建议先裁剪出文字区域,再执行识别,减少干扰信息。
5. 若识别结果中频繁出现错字,可以尝试在“设置”中切换识别引擎,或更新语言包,部分语言模型对特定字体支持更好。
6. 对于扫描件或PDF文件,建议先使用软件的“PDF转图片”功能,将每一页转换为高清图片后再进行批量识别。
7. 定期检查软件更新,新版本通常会优化识别算法,提升整体性能。
万能文字识别电脑版支持哪些输出格式?能否直接复制文字?
1. 万能文字识别电脑版支持多种输出格式,包括纯文本(TXT)、Word文档(DOCX)、Excel表格(XLSX)以及PDF文件,满足不同场景需求。
2. 识别完成后,文字会直接显示在软件界面的文本编辑框中,用户可以像使用记事本一样直接复制、剪切或编辑内容。
3. 若需要导出为Word格式,点击“导出”按钮,在弹出菜单中选择“导出为Word”,软件将自动保留原有排版和段落结构。
4. 对于表格类图片,选择“导出为Excel”可智能还原表格结构,方便后续数据处理。
5. 软件还提供了“复制到剪贴板”快捷键,直接按Ctrl+C即可复制全部识别文字,粘贴到任意位置。
6. 此外,用户可以将识别结果保存为PDF,方便归档和分享,且支持加密和权限设置。
7. 在批量识别模式下,可分别导出每个文件的识别结果,也可以合并为一个文件,灵活应对不同需求。
万能文字识别电脑版可以识别手写文字吗?
1. 万能文字识别电脑版内置了手写体识别模型,能够识别较为工整的中英文手写文字,但潦草字迹的准确率会有所下降。
2. 使用手写识别时,建议将图片中的手写内容放大至合适尺寸,并确保笔迹清晰、无连笔过多的情况。
3. 在识别设置中,将“识别语言”调整为“中文手写”或“英文手写”模式,可针对性地提升识别效果。
4. 软件支持对手写笔记进行智能分段和标点补充,输出结果更符合阅读习惯。
5. 若手写图片包含多种颜色或背景,先利用图像处理功能将背景统一为白色,可减少干扰。
6. 对于特别潦草的手写体,识别后可能需要手工修正,软件提供了“对比原图”功能,方便逐字校对。
7. 该功能对于学生笔记电子化、会议记录整理等场景非常实用,能大幅节省手动输入时间。

万能文字识别电脑版的快捷键大全
| 快捷键 | 功能 |
|---|---|
| Ctrl+O | 打开图片文件 |
| Ctrl+S | 保存识别结果 |
| Ctrl+C | 复制选中文字 |
| Ctrl+V | 粘贴文字 |
| Ctrl+A | 全选文字 |
| Ctrl+Z | 撤销操作 |
| Ctrl+Y | 重做操作 |
| F5 | 开始识别 |
| F6 | 批量识别 |
| Ctrl+P | 打印识别结果 |
| Ctrl+E | 导出为Word |
| Ctrl+Shift+E | 导出为Excel |
万能文字识别电脑版配置需求高吗?运行环境要求
| 项目 | 最低配置 | 推荐配置 |
|---|---|---|
| 操作系统 | Windows 7/8/10 | Windows 10/11 |
| 处理器 | 1.0 GHz 双核 | 2.4 GHz 四核及以上 |
| 内存 | 2 GB | 4 GB及以上 |
| 硬盘空间 | 200 MB可用空间 | 500 MB可用空间 |
| 显卡 | 集成显卡 | 独立显卡 |
| 网络 | 非必须(离线识别) | 建议联网以更新模型 |
| 其他 | 无 | 安装.NET Framework 4.6 |
万能文字识别电脑版有没有使用技巧或秘籍?
1. 巧用“截图识别”功能:软件内置截图工具,按下快捷键Ctrl+Alt+A即可直接截取屏幕任意区域并立即进行文字识别,无需先保存图片。
2. 利用“表格还原”功能:对于有边框的表格图片,选择“表格识别”模式,软件会自动识别表格线并生成可编辑的Excel表格,极大提升数据处理效率。
3. 批量重命名技巧:在批量识别时,可为输出文件设置自动命名规则,如“原文件名+识别时间”,便于文件管理。
4. 使用“翻译”功能:识别后的文字可以直接点击“翻译”按钮,软件内置多语言翻译引擎,支持中英日韩等几十种语言互译,方便跨语言工作。
5. 定期更新词库:软件允许用户添加自定义词库,针对专业术语或生僻字,可手动添加到词库中,提高后续识别准确率。
6. 云服务同步:登录账号后,可将识别历史记录同步到云端,在不同设备间随时查看和下载,方便办公。
7. 若遇到识别结果乱码,可尝试更改“字符集”设置,或在“高级选项”中调整“识别模式”为“高精度”或“快速”模式,以适应不同场景。


 OnePlus_15