AutoClaw自动抓取工具使用教程与实战技巧
来源: 资讯君 2026/10/2 13:22:22 浏览量:0
最近不少朋友在问 AutoClaw 这个自动抓取工具到底怎么上手,说实话我一开始也踩了不少坑,装完不知道从哪下手,规则写错爬出来一堆乱码。这篇文章就把我自己用 AutoClaw 的完整过程捋一遍,从下载安装到写出能跑的采集规则,再到实战里遇到的反爬和报错,全都摊开讲。不管你是做数据采集的新手,还是想找个顺手的抓取工具替代手写脚本,看完基本能自己跑通一个项目。
- 应用名称:AutoClaw1.6.0 安卓版 下载地址:https://m.fxxz.com/f/774815
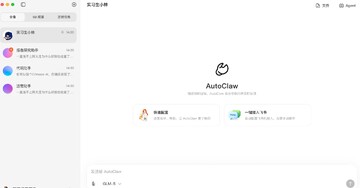
AutoClaw 是什么,适合哪些人用
简单说,AutoClaw 是一款可视化的自动抓取工具,你不用一上来就啃 Python 爬虫框架,靠点选和简单配置就能把网页上的标题、链接、价格、评论这些字段扒下来。它最舒服的地方是规则和采集分开管,改一个选择器不用重写整个脚本。
适合的人群其实挺广:做电商比价的、盯竞品价格的、收集行业资讯做内容站的,还有学生做课题要批量抓公开数据的。但要说清楚,AutoClaw 是工具不是万能钥匙,遇到强验证码和复杂加密接口,还是得配合其他手段,别指望一键搞定所有网站。
下载安装与首次配置,别急着点开始
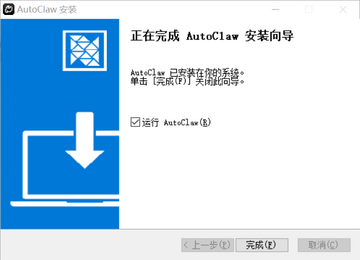
安装包从官网拿就行,注意看清系统版本,Windows 和 Mac 的包不通用。装完第一次打开会让你选工作目录,这一步别偷懒,专门建个文件夹放项目,不然采集数据一多,文件散得到处都是,后面找起来想哭。
首次配置里有个请求间隔的设置,默认值偏快。我的建议是新手直接调到 2 到 3 秒,AutoClaw 跑起来稳比快重要,尤其目标站点服务器一般的话,请求太密很容易被限流。代理配置可以先跳过,等真被拦了再回来填。
规则怎么写,选择器是核心
写规则是 AutoClaw 最关键的一步。打开目标网页,按 F12 看元素结构,找到你要抓的字段对应的标签,把 class 或 id 填进选择器框里。这里有个新手常犯的错:直接复制浏览器给的绝对路径,网页结构一变就全废。尽量用相对选择器,稳得多。
列表页和详情页要分开写规则。列表页抓链接,详情页抓正文,AutoClaw 支持两级联动,配好之后它会自动顺着链接往下翻。我一般先拿一页试跑,确认字段都对得上,再放开翻页数量,不然错误会被放大几十倍。
实战采集:从试跑到批量抓取
真正开跑前,先用 AutoClaw 的单页测试功能跑一遍,看看抓下来的数据干不干净。常见问题是抓到多余空格、换行,或者图片链接是相对路径,这些在规则里加个清洗步骤就能解决。
批量抓取时盯着日志看,出现大量 403 或 429 就说明被盯上了,赶紧降速或者换 IP。我自己的习惯是每抓五百条停一下,导出一次数据,避免跑到一半崩了前功尽弃。数据导出支持 CSV 和 JSON,做分析的选 CSV,要继续喂给程序的选 JSON。
常见报错和处理办法
用 AutoClaw 遇到最多的就是选择器匹配不到元素,八成是网页用了动态加载,数据还没渲染出来工具就开始抓了。解决办法是在规则里加等待时间,或者换成抓接口返回的 JSON 数据,比硬扒 DOM 靠谱。
还有就是编码乱码,中文站尤其常见。在 AutoClaw 的项目设置里把编码手动指定成 GBK 或 UTF-8,一般就能正常显示。如果碰到登录才能看的内容,可以配置 Cookie,把浏览器里登录后的 Cookie 复制进去,注意别泄露出去。
一些提升效率的小技巧
规则写多了可以存成模板,同类网站直接套用,省得每次重来。定时任务功能也值得用起来,AutoClaw 支持按小时或按天自动跑,做行情监控特别合适。另外采集前先看目标站的 robots.txt,别硬闯明令禁止的目录,既是规矩也能少惹麻烦。
最后提醒一句,抓来的数据自己分析用没问题,别原样搬运发布,版权和合规风险得自己掂量。工具是好工具,用对地方才发挥价值。